Radar Informacji
Automatyczne wykrywanie tematów, klastrowanie semantyczne i monitorowanie trendów w strumieniach wiadomości
Czym jest Radar Informacji?
Radar Informacji to w pełni zautomatyzowane środowisko do analizy bieżących trendów i wydarzeń w mediach. Codziennie przetwarza strumień setek artykułów z wiodących serwisów informacyjnych, identyfikując spójne klastry tematyczne, tworząc ich zwięzłe podsumowania oraz badając źródła i wydźwięk emocjonalny.
W przeciwieństwie do tradycyjnych agregatorów wiadomości, Radar Informacji nie korzysta ze sztywnych, z góry narzuconych kategorii (np. „Polityka”, „Sport”). Zamiast tego, nazwy i zakresy tematów są wyznaczane w sposób nienadzorowany na podstawie rzeczywistej zawartości i semantycznego podobieństwa napływających tekstów.
Narzędzie jest w 100% darmowe, nie wymaga logowania, nie wyświetla reklam i powstało w celach badawczo-edukacyjnych.
8-etapowy potok algorytmiczny
Proces generowania codziennych podsumowań opiera się na 8-krokowym deterministycznym potoku uczenia maszynowego:
[ 1. Web Stream ] ──> [ 2. Eksport JSONL ] ──> [ 3. Embeddingi 512D ]
                                                         │
[ 6. Etykiety GenAI ] <── [ 5. HDBSCAN ] <── [ 4. t-SNE / UMAP ]
         │
         ▼
[ 7. Synteza Podsumowania (~700 zn.) ] ──> [ 8. Dni Podobne (Bi-Encoder) ]
Krok 1: Pobieranie i normalizacja wiadomości
Cykliczny crawler pobiera artykuły i nagłówki z dziesiątek zróżnicowanych polskich i międzynarodowych serwisów newsowych, tworząc surowy strumień aktualności.
Krok 2: Eksport do formatu JSONL
Dane są ujednolicane do ustrukturyzowanego formatu JSONL zawierającego oczyszczony tekst oraz metadane:
{
  "text": "Treść lub nagłówek artykułu...",
  "metadata": {
    "language": "pl",
    "polarity_3c": "positive",
    "source": "NazwaPortalu",
    "news_url": "https://..."
  }
}
Krok 3: Generowanie gęstych wektorów (Sentence-Transformers)
Dla każdego artykułu generowany jest 512-wymiarowy wektor cech (embedding) za pomocą dedykowanego modelu Sentence-Transformers zoptymalizowanego dla języka polskiego: * Teksty powyżej 508 tokenów są bezpiecznie obcinane, * Wektory poddawane są normalizacji L₂ w celu bezpośredniego wykorzystania podobieństwa cosinusowego, * Przetwarzanie wsadowe (batch size 500) gwarantuje maksymalne wykorzystanie GPU.
Krok 4: Nieliniowa redukcja wymiarowości
Przestrzeń embeddingów jest redukowana z 512 wymiarów przy użyciu algorytmów t-SNE (metoda Barnes-Hut) lub UMAP. Pozwala to zachować zarówno lokalną strukturę gęstych skupisk powiązanych wiadomości, jak i globalne relacje między różnymi tematami.
Krok 5: Dynamiczne klastrowanie HDBSCAN
Zamiast stosować statyczny próg odcięcia, algorytm testuje 32 różne wartości parametru min_cluster_size (w zakresie od 5 do 60):
* Kryterium doboru preferuje konfigurację generującą optymalnie 25–45 klastrów tematycznych dziennie (ze złotym środkiem w okolicach 35 tematów),
* W przypadku remisu wybierana jest konfiguracja minimalizująca liczbę odrzuconych przykładów odstających (outliers).
Krok 6: Generatywne nazywanie tematów
Każde wyodrębnione skupisko artykułów przekazywane jest do modelu generatywnego LLM, który analizuje wspólny mianownik tekstów i tworzy trafną, precyzyjną nazwę tematu (np. „Wyprawa kosmiczna Artemis – postępy i testy napędu”).
Krok 7: Synteza zwięzłego podsumowania
Dla każdego klastra model językowy generuje obiektywne podsumowanie o długości około 700 znaków. Wyjściowy tekst przechodzi automatyczną weryfikację poprawności językowej i ortograficznej.
Krok 8: Wyszukiwanie Dni Podobnych (Similar Days)
Każdy dzień poddawany jest wektoryzacji dedykowanym modelem article-bi-encoder-20240901. Poprzez porównanie cosinusowe z historyczną bazą danych algorytm wskazuje do 10 najbardziej podobnych wydarzeń z dnia poprzedzającego.
Prezentacja danych w interfejsie użytkownika
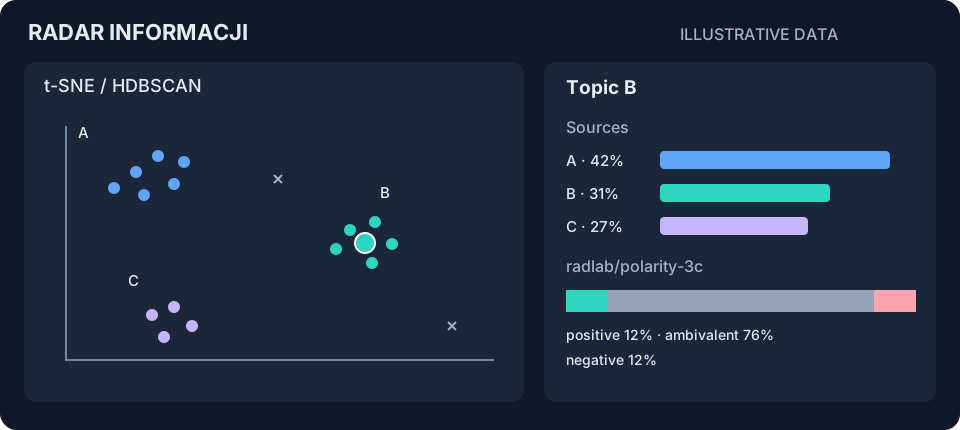
Aplikacja Radar Informacji łączy rzutowanie wielowymiarowej przestrzeni semantycznej z interaktywnymi kartami podsumowań:
Sprawdź rzeczywiste tematy i wykresy w Radarze Informacji.
Moduły analityczne i metryki
Radar Informacji wyposażony jest w zestaw narzędzi analitycznych:
- Wykres propagacji źródeł: Wizualizacja procentowego udziału poszczególnych portali w danym temacie, pozwalająca zbadać, które media zapoczątkowały lub zdominowały dany wątek.
- Wskaźnik polaryzacji emocjonalnej: Ocena wydźwięku tekstów w klastrze (pozytywny, negatywny, ambiwalentny) z wykorzystaniem modelu
radlab/polarity-3c. - Archiwum i kalendarz: Możliwość cofnięcia się do dowolnego dnia i prześledzenia dynamiki ewolucji tematów w czasie.
- Wykrywanie relacji (Eksplorator): Analiza grafowa powiązań między bytami i wątkami pojawiającymi się w wiadomościach.
Dostęp i integracja
- Aplikacja webowa: radar.apps.radlab.dev
- Dokumentacja techniczna algorytmu: radar.apps.radlab.dev/algorithm
- Status: W 100% darmowy, open-access, bez wymogu logowania.